
在前幾天的文章中,我們已經一步一步建立了 RAG 的前半段流程:
文件 -> 前處理 -> Chunking -> Embedding -> Vector Database -> Retriever
當使用者提出問題時,Retriever 會將問題轉換成向量,在從向量資料庫中找出與問題相似的文件片段。
看起來好像已經完成了「找資料」這件事。
但實際上還存在一個問題:
Retriever 找回來的內容,真的全部都與問題高度相關嗎?
答案通常是否定的。
因為 Retriever 的主要任務是「從大量資料中,快速找出一批可能相關的內容。」
而不是保證每一個結果都能直接回答使用者的問題,因此我們還需要一個機制,進一步判斷哪些內容最值得留下。
這就是 Rerank。
舉個例子,假設公司內部有一套知識庫,裡面包含各種請假規則、出勤規範與員工手冊。
今天使用者問:「特休一天需要提前幾天申請?」
Retriever 可能會根據語意相似度,找回以下幾個 Chunk:
仔細看會發現,這些 Chunk 其實不是完全不相關
他們都提到了:
所以 Retriever 把它們找回來,其實是合理的。
但如果我們重新看一次使用者的問題:
「特休一天需要提前幾天申請?」
就會發現,不同 Chunk 對這個問題的幫助程度其實不同。
例如:
所以真正的問題不是:「這些資料相關嗎?」
而是:「這些資料和目前這個問題,到底有多相關?」
這就是 Rerank 要處理的事情。
Rerank 可以理解成 Retriever 後面的第二階段排序機制。
它會接收到 Retriever 找回來的候選結果再進一步判斷:「哪一個 Chunk 最符合使用者真正想問的事情?」
整個流程會變成: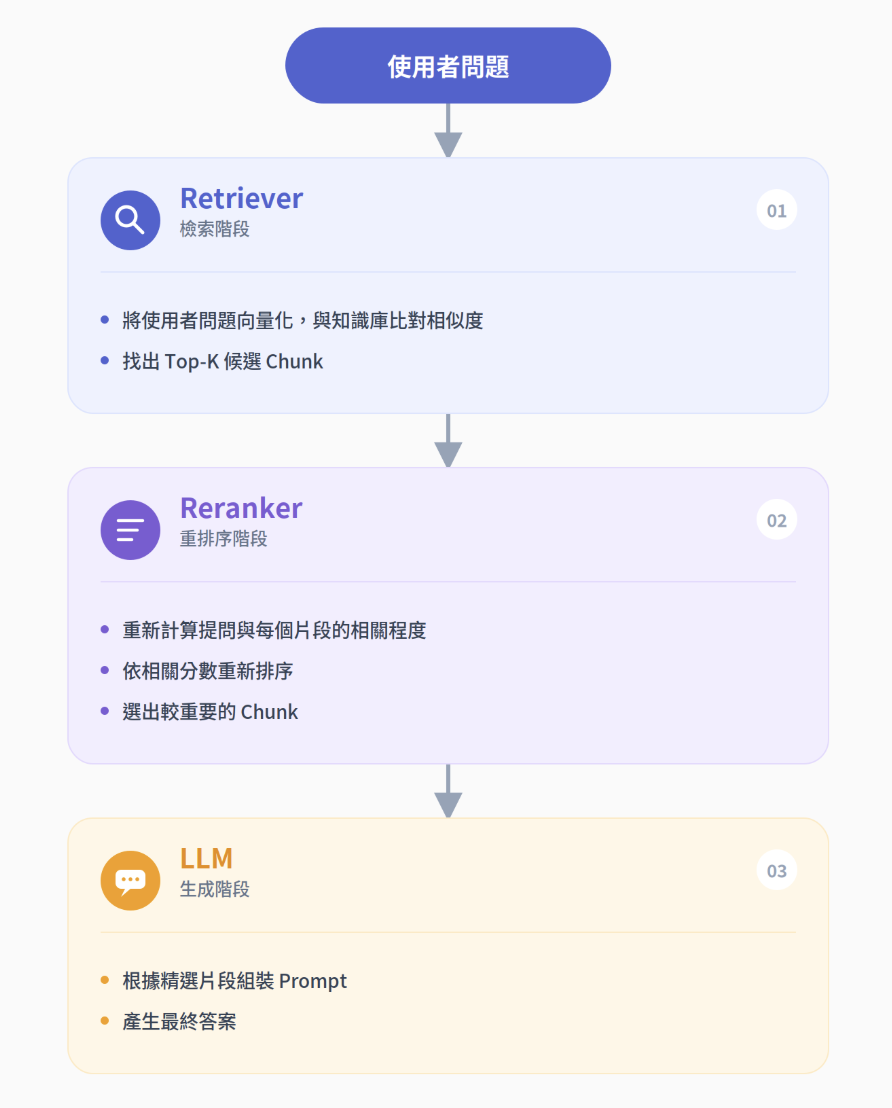
例如 Retriever 找回 20 個候選 Chunk
Rerank 可以再針對這 20 個結果進行更細緻的相關性判斷,最後選出排名較前的內容列如 Top-5。
概念上可能會變成: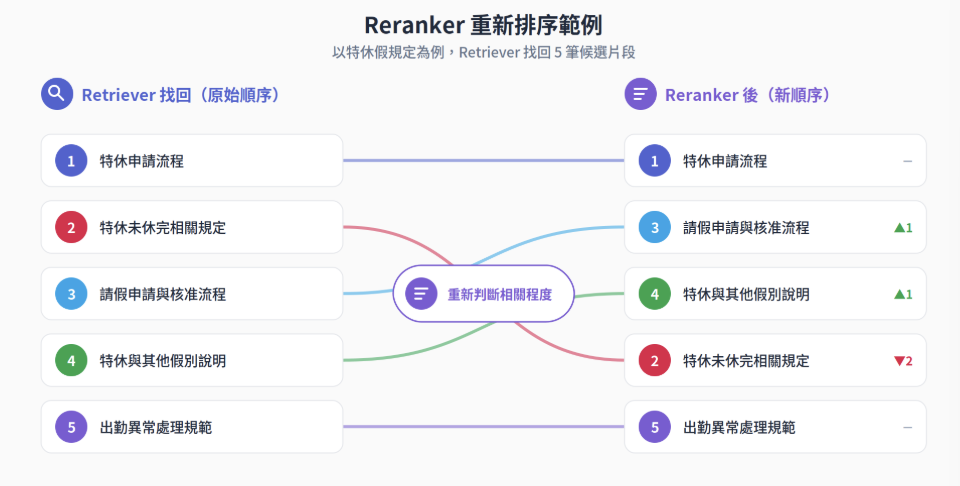
這裡最重要的不是「最後一定會變成這個順序」,而是要理解:
Retriever 找的是「可能相關的候選資料」,Rerank 則進一步把候選資料按照與問題的相關程度重新排序。


 iThome鐵人賽
 看影片追技術